初探 Java 基础
初探 Java 系列第一篇,本文的目的仅在于对 Java 基础部分知识点查漏补缺以及深入理解,而并非带你从零开始学习 Java,所以需要对 Java 已经有简单的了解。
在阅读本文之前,推荐先阅读初探计算机基础系列。
Java 的基本概念
先简单的介绍一下关于 Java 的一些基本常识。
JVM,JDK,JRE 都是些什么
JVM 是 Java 虚拟机,用来运行 Java 字节码,JVM 有针对不同系统的特定实现(Windows,Linux,MacOS),目的是使用相同的字节码,它们都会给出相同的结果。
JDK 是 Java Development Kit,它是功能齐全的 Java SDK。它拥有 JRE 所拥有的一切,还有编译器(javac)和工具(如 javadoc 和 jdb)。它能够创建和编译程序。
JRE 是 Java 运行时环境。它是运行已编译 Java 程序所需的所有内容的集合,包括 Java 虚拟机(JVM),Java 类库,Java 命令和其他的一些基础构件。但是它不能用于创建新程序。
如果只是为了运行一下 Java 程序的话,那么只需要安装 JRE 就可以了。如果需要进行一些 Java 编程方面的工作,那么就需要安装 JDK 了。但是这不是绝对的。有时即使不打算在计算机上进行任何 Java 开发,仍然需要安装 JDK,这种情况往往出现于你的计算机上的其它软件需要依赖于 Java 环境。
为什么说 Java 语言是“编译与解释共存”
Java 语言既具有编译型语言的特征,也具有解释型语言的特征。因为 Java 程序要经过先编译,后解释两个步骤。由 Java 编写的程序需要先经过编译步骤,生成字节码文件(*.class 文件),这种字节码必须由 Java 解释器来解释执行。因此,我们可以认为 Java 语言编译与解释并存。
高级编程语言按照程序的执行方式分为编译型和解释型两种。简单来说,编译型语言是指编译器针对特定的操作系统将源代码一次性翻译成可被该平台执行的机器码,比如 C/C++;解释型语言是指解释器对源程序逐行解释成特定平台的机器码并立即执行,比如 Python。
Object 类是一切的始祖
整个源代码五百多行,看起来很多,但其实大部分都是英文注释说明,整个 Object 类并没有多少东西。
现在至少要知道作为 Java 最核心的类之一的 Object 中到底有哪几个方法。至于它们各自的作用的详细分析,此时无需关心过多,简单了解即可,往后到了合适的地方再做补充解释。
Object 类是整个类层次结构的根,每个类都会将 Object 作为超类,所有的对象,包括数组都会实现此类的方法。
public class Object {

    private static native void registerNatives();
    static {
        registerNatives();
    }

    public final native Class<?> getClass();

    public native int hashCode();
    public boolean equals(Object obj) {
        return (this == obj);
    }

    protected native Object clone() throws CloneNotSupportedException;

    public String toString() {
        return getClass().getName() + "@" + Integer.toHexString(hashCode());
    }

    public final native void notify();
    public final native void notifyAll();
    public final native void wait(long timeout) throws InterruptedException;
    public final void wait(long timeout, int nanos) throws InterruptedException {
        if (timeout < 0) {
            throw new IllegalArgumentException("timeout value is negative");
        }
        if (nanos < 0 || nanos > 999999) {
            throw new IllegalArgumentException("nanosecond timeout value out of range");
        }
        if (nanos > 0) {
            timeout++;
        }
        wait(timeout);
    }
    public final void wait() throws InterruptedException {
        wait(0);
    }

    protected void finalize() throws Throwable { }
}
Object.equals(Object obj) 在比较什么
直接从源码里面找到 Object.equals(Object obj)。
public boolean equals(Object obj) {
    return (this == obj);
}
很明显,这里直接返回了 == 的结果,在 Java 中,== 是在直接比较两个 Object 对象的内存地址是否相同。
Object.hashCode() 用来计算散列码
hashCode() 的作用是获取哈希码,也称为散列码;它实际上是返回一个 int 整数,这个哈希码的作用是确定该对象在哈希表中的索引位置。
hashCode() 定义在 Object 类中,这意味着 Java 中的任何类都包含有 hashCode() 函数。
虽然每个 Java 类都包含 hashCode() 函数。但是仅仅当创建某个类的散列表时,该类的 hashCode() 函数才会起作用,用来确定每一个对象在散列表中的位置,其他情况下一个类的 hashCode() 函数并没有作用。
equals() 和 hashCode() 的关系
当我们不去使用 HashSet、Hashtable、HashMap 等等这些本质是散列表数据结构的类时,该类的 hashCode() 和 equals() 没有关系。
反之则是有关系的:如果两个对象相等,那么它们的 hashCode() 返回值一定相同,即通过 equals() 比较两个对象时返回 true;但是如果两个对象 hashCode() 返回值相等,它们 equals() 返回结果并不一定相等,
这个概念最早出现于数据结构中。简单来说,两个不同的键,它们的哈希值相等,就是哈希冲突。想要详细理解可以阅读初探数据结构与算法
== 和 equals() 的关系
equals() 方法有两种使用情况。
情况 1:类没有重写 equals() 方法。则通过 equals() 比较该类的两个对象时,等价于通过 == 比较这两个对象。
情况 2:类重写了 equals() 方法。一般我们都重写 equals() 方法来比较两个对象的内容相等,若它们的内容相等,则返回 true (即认为这两个对象的值相等)。
public static void main(String[] args) {
    String a = new String("ab"); // a 为一个引用
    String b = new String("ab"); // b为另一个引用,对象的内容一样
    String aa = "ab"; // 放在常量池中
    String bb = "ab"; // 从常量池中查找
    if (aa == bb) // true
          System.out.println("aa==bb");
    if (a == b) // false,非同一对象
        System.out.println("a==b");
    if (a.equals(b)) // true
        System.out.println("aEQb");
}
& 和 && 的区别
& 运算符是按位与。即将两侧的数用二进制展开,每一位都进行与运算,最后得到的二进制数就是结果。
&& 运算符是逻辑与。即要求运算符左右两端的布尔值都是 true 时整个表达式的值才是 true。&& 又被称为短路运算,即如果 && 左边的表达式的值是 false,右边的表达式会被直接短路掉,不会进行运算。
逻辑或运算符(|)和短路或运算符(||)的差别也是如此。
switch 的操作数可以是字符串,不能是 long 和 浮点数
从 Java 7 开始,可以在 switch 条件判断语句中使用 String 对象。
String s = "a";
switch (s) {
    case "a":
        System.out.println("aaa");
        break;
    case "b":
        System.out.println("bbb");
        break;
}
switch 不支持 long、float、double,是因为 switch 的设计初衷是对那些只有少数几个值的类型进行等值判断,如果值过于复杂,那么还是用 if 比较合适。
Java 的基本数据类型
在 Java 中,一共有两大数据类型:基本数据类型(内置数据类型)、引用数据类型。
其中 Java 语言支持 8 种基本数据类型。
| 基本 | 位数 | 字节 | 默认 |
|---|---|---|---|
| byte | 8 | 1 | 0 |
| short | 16 | 2 | 0 |
| int | 32 | 4 | 0 |
| long | 64 | 8 | 0L |
| char | 16 | 2 | ‘u0000’ |
| float | 32 | 4 | 0f |
| double | 64 | 8 | 0d |
| boolbean | false |
Java 没有无符号整数
是的,Java 没有无符号整数,这是和 C/C++ 不一样的地方之一。
定义 short s = 1,那么 s = s + 1 和 s += 1 的不同
short s = 1;
s = s + 1;

short s = 1;
s += 1;
对于 s = s + 1,由于 1 是 int 类型,因此 s + 1 运算结果也是 int 类型,需要强制转换类型才能赋值给 short。
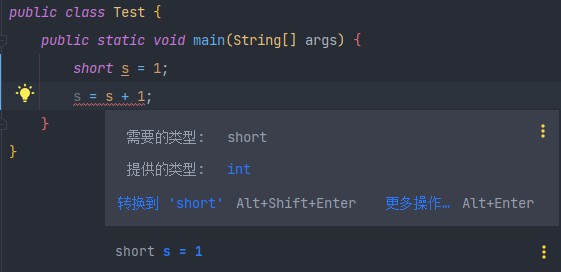
对于 s += 1,可以正确的进行编译,这个语句相当于 s = (short) (s + 1),其中有隐含的强制类型转换。
boolean 的大小是多少
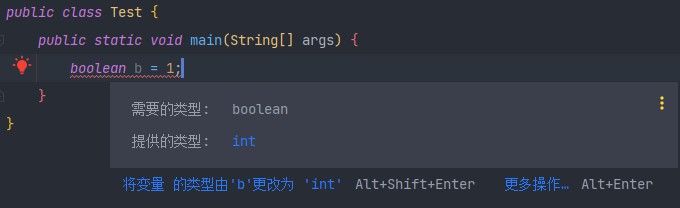
boolean 类型的大小是没有给出精确的定义的,《Java 虚拟机规范》给出了 4 个字节,和 boolean 数组 1 个字节的定义,但是具体还要看虚拟机实现是否按照规范来,所以 1 个字节、4 个字节都是有可能的。这其实是运算效率和存储空间之间的博弈,两者都非常的重要。
在 Java 中,整型值 int 和布尔值 boolean 之间不能进行相互转换(与 C++ 不同)。
float f = 3.4,是否是正确的
不正确。3.4 是双精度数,将双精度型 double 赋值给浮点型 float 属于下转型(down-casting,也称为窄化)会造成精度损失,因此需要强制类型转换 float f =(float) 3.4; 或者写成 float f = 3.4F。
float f =(float) 3.4;
float f = 3.4F;
浮点数值不适用于无法接受舍入误差的金融计算中。例如 System.out.println(2.0 - 1.1) 将打印出 0.8999999999999999,而不是我们想象的 0.9。这种舍入误差的主要原因是浮点数值采用二进制系统表示,而在二进制系统中无法精确地表示分数 1/10。这就好像十进制无法精确地表示分数 1/3 一样。如果在数值计算中不允许有任何舍入误差,就应该使用 BigDecimal 类。
"\u0022"、"\u0022+\u0022",分别会打印什么
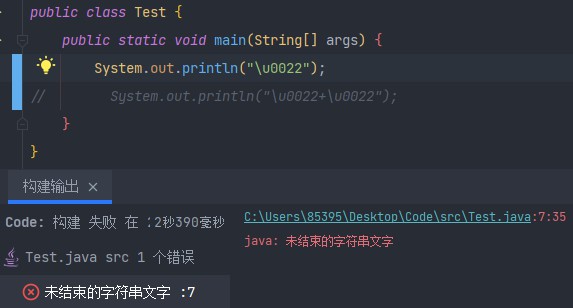
System.out.println("\u0022") 会报错,因为 Unicode 转义序列会在解析代码之前得到处理。这里 \u0022 会被处理成一个引号,也就是三个连续的引号。
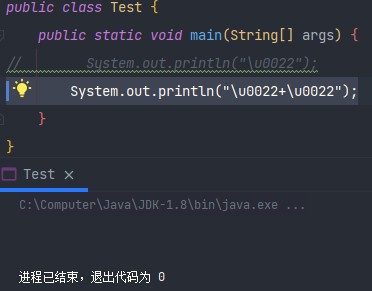
System.out.println("\u0022+\u0022") 会打印一个空串,你要能搞明白上面那个问题,所以这个地方 "\u0022+\u0022" 并不是一个由引号 \u0022 包围加号构成的字符串。 实际上,\u0022 会在解析之前转换为 ", 这会得到 ""+"",也就是一个空串。
Java 的包装类
Java 是一个近乎纯洁的面向对象编程语言,但是为了编程的方便还是引入了基本数据类型,但是为了能够将这些基本数据类型当成对象操作,Java 为每一个基本数据类型都引入了对应的包装类型(wrapper class),int 的包装类就是 Integer,从 Java 5 开始引入了自动装箱/拆箱机制,使得二者可以相互转换。
8 种基本数据类型都有对应的包装类分别为:Byte、Short、Integer、Long、Float、Double、Character、Boolean。
装箱和拆箱是什么
- 装箱:将基本类型用对应的引用类型包装起来。
- 拆箱:将包装类型转换为对应的基本数据类型。
Integer x = 2;  // 装箱
int y = x;      // 拆箱
装箱过程是通过调用包装器的 valueOf() 方法实现的,而拆箱过程是通过调用包装器的 xxxValue() 方法实现的。
包装类与常量池技术
Java 基本类型的包装类的大部分都实现了常量池技术,即 Byte、Short、Integer、Long、Character、Boolean。前面 4 种包装类默认创建了数值 [ -128, 127 ] 的相应类型的缓存数据,Character 创建了数值在 [ 0 , 127 ] 范围的缓存数据,Boolean 直接返回 True 或者 False。如果超出对应范围仍然会去创建新的对象。
倘若你不理解这里的内容,也不用着急,安心往下看,马上就解决你的疑惑。
为什么把缓存设置为 [ -128, 127 ] 区间,主要是考虑到性能和资源之间的权衡。
==、equals 与包装类产生的奇妙化学反应
Integer a = new Integer(123);
Integer b = Integer.valueof(123);
Integer c = 123;
int d = 123;
这四种不同的 123 的赋值方式,它们之间的区别,是 Java 基础里比较重要的一个地方,接下来我会先从例子开始,再到源码,一点点的将它弄明白。
Integer 重写了 Object 中的 equals 方法
public static void main(String[] args) {
    Integer a = new Integer(123);
    Integer b = new Integer(123);
    System.out.println(a == b);      // false
    System.out.println(a.equals(b)); // true
}
这段程序的结果是什么呢?我想如果是对 Java 有一定的了解的同学应该知道答案,第一行是 false,第二行是 true。
不知道还记不记得本文最开头介绍 Object 类的时候,有介绍过 Object.eqauls(object)在比较什么,这个方法本质其实就是 ==,按道理来说 == 和 equals() 中应该是一样的结果,那么为什么此刻他们的结果不一样呢?
原因其实很简单,Object 类一切的始祖,所有的类都会继承 Object,Integer 继承了 Object 然后重写了 equals() 方法,重写后的 equals() 方法不再是比较两个变量的地址了,而是比较两个变量的值。
public boolean equals(Object obj) {
    if (obj instanceof Integer) {
        return value == ((Integer)obj).intValue();
    }
    return false;
}
Integer 中的常量池缓存
现在我们对上面的那个例子的代码稍作修改,改成使用 Integer.valueOf() 方法来创建对象。
public static void main(String[] args) {
    Integer a = Integer.valueOf(123);
    Integer b = Integer.valueOf(123);
    System.out.println(a == b);
    System.out.println(a.equals(b));
}
你会发现这里的结果发生了变化,两个结果都是 true,这说明 a 和 b 不仅仅只有值是相同的,甚至连所引用的 123 的地址都是一样的。为什么呢,这个就是刚才说到的常量池技术。
public static Integer valueOf(int i) {
    if (i >= IntegerCache.low && i <= IntegerCache.high)
        return IntegerCache.cache[i + (-IntegerCache.low)];
    return new Integer(i);
}

private static class IntegerCache {
    static final int low = -128;
    static final int high;
    static final Integer cache[];
    static {
        // high value may be configured by property
        int h = 127;
        String integerCacheHighPropValue =
            sun.misc.VM.getSavedProperty("java.lang.Integer.IntegerCache.high");
        if (integerCacheHighPropValue != null) {
            try {
                int i = parseInt(integerCacheHighPropValue);
                i = Math.max(i, 127);
                // Maximum array size is Integer.MAX_VALUE
                h = Math.min(i, Integer.MAX_VALUE - (-low) -1);
            } catch( NumberFormatException nfe) {
                // If the property cannot be parsed into an int, ignore it.
            }
        }
        high = h;
        cache = new Integer[(high - low) + 1];
        int j = low;
        for(int k = 0; k < cache.length; k++)
            cache[k] = new Integer(j++);
        // range [-128, 127] must be interned (JLS7 5.1.7)
        assert IntegerCache.high >= 127;
    }
    private IntegerCache() {}
}
我们打开源码来看一看,IntegerCache 是 Integer 类里面的一个静态类;valueOf() 方法的内容不多,很容易懂,就是如果调用了 valueOf(),会先判断一下在不在 IntegerCacghe.low 到 IntegerCache.high 的范围里面(这个范围就是[ -128, 127 ]),在的话就直接读缓存里的数据,不然就 new 一个 Integer 对象。
public static void main(String[] args) {
    Integer a = Integer.valueOf(129);
    Integer b = Integer.valueOf(129);
    System.out.println(a == b);
    System.out.println(a.equals(b));
}
所以当我们把 valueOf() 方法的参数变成 [ -128, 127 ] 外的数以后,第一行的结果就是 false 了。
直接赋值是装箱的过程
public static void main(String[] args) {
    Integer a = 126;
    Integer b = 126;
    Integer c = 200;
    Integer d = 200;
    System.out.println(a == b);
    System.out.println(c == d);
}
这段代码的结果是 true 和 false,直接复制的时候,会将右侧的常量值自动装箱,本文之前有提到过,装箱的过程是调用 valueOf() 方法的过程。
Integer 拆箱后与 int 比较
public static void main(String[] args) {
    Integer a = 129;
    int b = 129;
    System.out.println(a == b);
    System.out.println(a.equals(b));
}
想想这段代码的结果是什么,其实就两个可能性:一是 a 拆箱成 int 与 b 比较,拆箱以后就是 int == int,那么结果肯定是 true;二是 b 装箱成 Integer 与 a 比较,装箱以后就是 Integer == Integer,由于 129 在缓存区间外,所以结果肯定是 false。
实际上的结果是 true,也就是说 Integer 与 int 比较的结果,是 Integer 自动拆箱后在比较的结果。
Double 中的一些特别的常量
常量 Double.POSITIVE_INFINITY、 Double.NEGATIVEJNFINITY 、Double.NaN(以及相应的 Float 类型的常量)分别表示这三个特殊的值,但在实际应用中很少遇到。
特别要说明的是,不能这样检测一个特定值是否等于 Double.NaN。
if (x == Double.NaN) // is never true
所有非数值的值都认为是不相同的。然而,可以使用 Double.isNaN 方法。
if (Double.isNaN(x)) // check whether x is not a number
Java 的字符串
Java 中的字符串是只读字符串,对它的任何操作,其实都是创建一个新的对象,然后将变量的引用指向该对象。这也被称作不可变。不可变的一个主要作用在于在多线程场景下,可以保证数据的一致性。
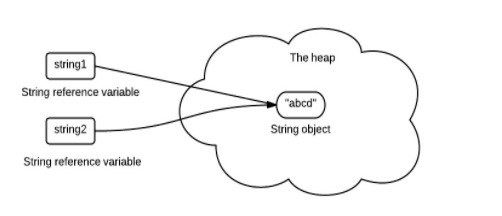
Java 字符串的另一个特性是常量池优化,很上文我们提到的包装类常量池技术类似,当 String 对象创建之后,会在字符串常量池中进行缓存,如果下次创建同样的对象是,会直接返回缓存的引用。
关于字符串常量池,以后会在初探 Java 虚拟机一文中在做介绍。
String 的最大长度其实是有限的
首先要明白 String 本身从逻辑概念上来说是没有最大长度限制的,但是需要知道的是,String 类内部是使用 char 数组或者 byte 数组来存储数据的,而 Java 中的数组其实是引用对象,本身有一个 length 属性(注意是 length 属性,而不是 length() 方法)。也就是说 String.length() 方法的具体实现其实就是返回了 value.length。
因为数组的 length 属性是一个 int 类型的变量,而 int 本身是由长度限制的,所以 String 在实际实现上允许的最大长度就是 2^32 - 1 = 2147483647。
实际上这个值也不太对,因为 Java 虚拟机会为数组的对象头保留一些空间,所以实际上还要在小一些,通常要再小 8 个字节。
但是这个说法是仅仅针对字符串变量而言,如果是写在代码中的字面量,那么允许的最大长度取决于字符串在常量池中的存储大小,也就是字符串在 class 格式文件中的存储格式。
CONSTANT_Utf8_info {
    u1 tag;
    u2 length;
    u1 bytes[length];
}
u2 是无符号的 16 位整数,因此理论上允许的字面量的最大长度是 2^16 - 1 = 65535。
然而实际测试表明,使用 javac 编译时允许的最大长度仅为 65534,超过就编译错误。
String str = "xxxx...xxx";
也就是说 str 的最大长度是 2147483647,而写在代码中的,双引号中的内容最大长度是 65534。
String 类为什么是不可变的
从 Java 8 和 Java 9 以后两个版本的源码来看。
在 Java 8 中,String 内部使用了 char 数组存储数据。
public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    // The value is used for character storage.
    private final char value[];
}
在 Java 9 后,String 内部的实现改用 byte 数组存储字符串,同时使用了一个 名字叫做 coder 的 byte 类型变量作为标识,来表示使用了哪种编码。
public final class String implements java.io.Serializable, Comparable<String>, CharSequence {
    // The value is used for character storage.
    private final byte[] value;
    // The identifier of the encoding used to encode the bytes in {@code value}
    private final byte coder;
}
有两个地方是我们要注意的:一个是保存值的 value 数组被声明为 final,这意味着 value 数组在初始化之后就不能再引用其它数组,并且 String 内部也没有改变 value 数组的方法,这也就是保证 String 不可变的方式;二是要注意 String 类本身也是一个 final 类型的类,表示 String 类不能被继承,可以提高系统的安全性。
String 不可变是内容不可变
String 不可变指的是所指向的引用中的内容不可变,引用本身却是可以变的。
String str = "Hello";
str = str + " World";
System.out.println("str =" + str);
实际上,原来 String 的内容是不变的(也就是"Hello"这个字符串本身),只是 str 这个变量由原来指向 "Hello" 的内存地址转为指向 "Hello World" 的内存地址而已,也就是说多开辟了一块内存区域给 "Hello World" 字符串。
String 类不可变带来了什么好处
第一是可以缓存 hash 值,因为 String 的 hash 值经常被使用,例如 String 用做 HashMap 的 key。不可变的特性可以使得 hash 值也不可变,因此只需要进行一次计算。
第二是 String Pool 的需要,如果一个 String 对象已经被创建过了,那么就会从 String Pool 中取得引用。只有 String 是不可变的,才可能使用 String Pool。
第三是安全性,String 经常作为参数,String 不可变性可以保证参数不可变。例如在作为网络连接参数的情况下如果 String 是可变的,那么在网络连接过程中,String 被改变,改变 String 的那一方以为现在连接的是其它主机,而实际情况却不一定是。
第四是线程安全,String 不可变性天生具备线程安全,可以在多个线程中安全地使用。
String.intern()到底是干嘛的
可以使用 String 的 intern 方法在运行过程将字符串添加到字符串常量池中。
当一个字符串对象调用 intern 方法时,如果字符串常量池中已经存在一个字符串和该字符串值相等(使用 equals 方法进行确定),那么就会返回字符串常量池中字符串的引用;否则就会在 字符串常量池中添加一个新的字符串,并返回这个新字符串的引用。
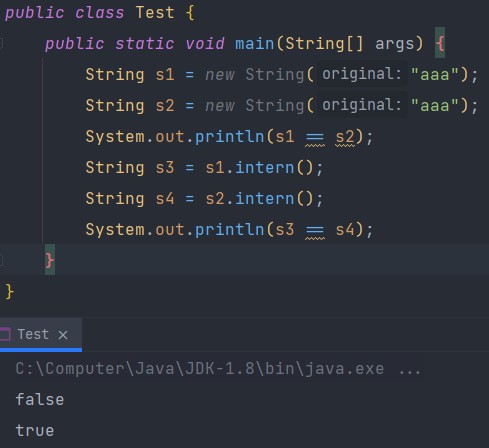
如果是采用字面量直接赋值的形式创建字符串,会自动地将字符串放入 String Pool 中。
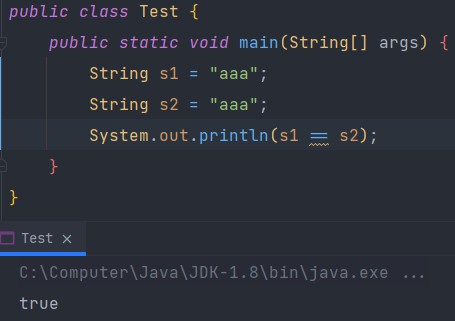
字符串常量池(String Pool)保存着所有字符串字面量(literal strings),这些字面量在编译时期就确定。
String、StringBuffer、StringBuilder 的区别
第一是可变性,String 类中使用被 final 声明的字符数组保存字符串,所以 String 对象是不可变的。StringBuilder 与 StringBuffer 都继承自 AbstractStringBuilder 类,在 AbstractStringBuilder 中也是使用字符数组保存字符串,这两种对象都是可变的。
然后是线程安全性,String 中的对象是不可变的,也就可以理解为常量,线程安全。AbstractStringBuilder 是 StringBuilder 与 StringBuffer 的公共父类,定义了一些字符串的基本操作,如 expandCapacity、append、insert、indexOf 等公共方法。StringBuffer 对方法加了同步锁或者对调用的方法加了同步锁,所以是线程安全的。StringBuilder 并没有对方法进行加同步锁,所以是非线程安全的。
最后是性能,每次对 String 类型进行改变的时候,都会生成一个新的 String 对象,然后将指针指向新的 String 对象。StringBuffer 每次都会对 StringBuffer 对象本身进行操作,而不是生成新的对象并改变对象引用。相同情况下使用 StirngBuilder 相比使用 StringBuffer 仅能获得 10% ~ 15% 左右的性能提升,但却要冒多线程不安全的风险。